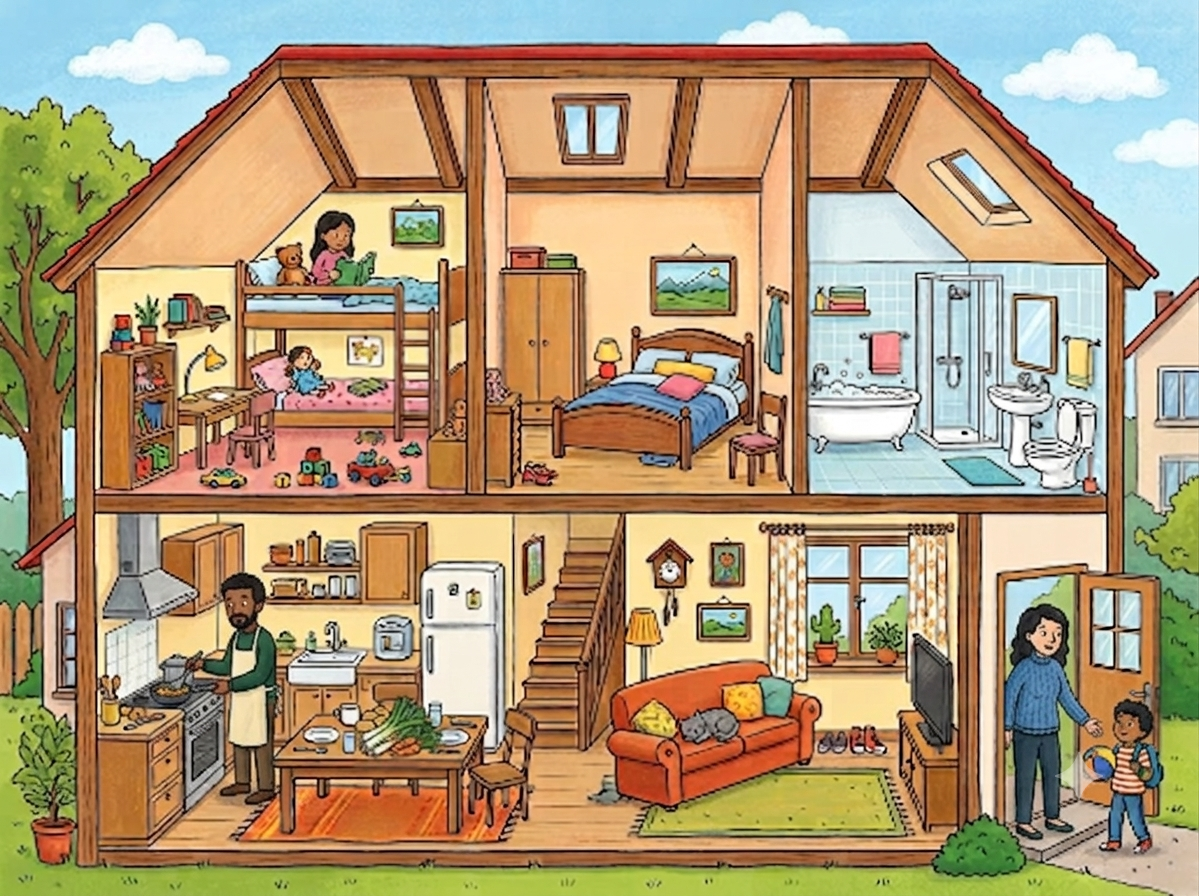
Im Unterricht, in der Sprachförderung oder in der Sprachtherapie benötigt man oft spezifische Wortlisten nach bestimmten Kriterien, idealerweise auch als Bilder aufbereitet, z.B. als Einstieg in ein Unterrichtsthema und zur Wortschatzvorentlastung oder als Screening für bestimmte Zielstrukturen:
- Ein Wimmelbild zu den häufigsten Wörtern der Kindersprache zum Themenfeld „zu Hause“ für den DAZ-Unterricht
- Ein Begriffsliste zum Thema „Das verkehrssichere Fahrrad“, als Basis für die Planung einer Sequenz im Sachunterricht 4. Klasse
- Ein Wimmelbild mit den häufigsten Wörtern der Kindersprache für ein informelles Sprachscreening
Mit Hilfe von Künstlicher Intelligenz (KI) und automatisierter Auswertung des Kindersprachkorpus ChildLex ergeben sich für diese Anwendungskontexte ganz neue Möglichkeiten.
Grundidee des Vorgehens ist:
- Eine Wortliste basierend auf den Häufigkeitswerten eines Kindersprachkorpus zusammenstellen lassen (ChildLex).
- Aus dieser Wortliste mit Hilfe eines KI-Systems (z.B. ChatGPT, Google Gemini) ein Wimmelbild oder Einzelbilder erzeugen lassen.
Wie geht das nun?
1. Die Wortliste mit ChildLex erstellen lassen
Um fundiert Wortlisten zu erstellen, empfiehlt es sich, nicht einfach nur zu fragen „Finde 20 Wörter der Kindersprache zum Thema „zu Hause/Familie““ etc., sondern wirklich forschungsbasiert und fundierter vorzugehen, indem man wissenschaftliche Analysen von Häufigkeiten des Kinderwortschatzes zu Grunde legt. In einem Korpus ist eine große, digitalisierte Zusammenstellung von Texten oder auch hier Kindersprache, meist bestehend aus einer Liste der gefundenen Wörtern und weiteren zugeordneten Kennzahlen (z.B. absolute oder relative Häufigkeit). Es finden sich neben den Wörtern der Kinder an sich also auch linguistische Informationen wie Häufigkeiten zu jedem Wort.
Hier wird das Kindersprachkorpus „ChildLex“ verwendet, da es besonders leicht nutzbar und frei zugänglich ist: Es steht online als Download zur Verfügung, ist ohne Login nutzbar, verfügbar als lesbare Excel-Datei ohne dass weitere Auswertungstools benötigt werden, hat eine große Datenbasis und steht unter Lizenz GNU General Public License (GPL) 3.0, darf also meines Wissens nach auch auf diese Weise verarbeitet werden.
Bei ChildLex handelt es sich um eine „umfangreiche lexikalische Datenbank zur Schriftsprache für Kinder im Deutschen … Das Korpus basiert auf einer Sammlung von 500 Büchern, die Kinder im Alter zwischen 6 und 12 Jahren lesen“ (vgl. https://www.dwds.de/d/korpora/childlex). Man muss sich also bewusst sein, dass es nicht direkt gesprochene Kindersprache zusammenstellt, dafür aber eine sehr umfangreiche Datenbasis verwendet und auch für dezidierte Altersgruppen ausweist.
Folgender Prompt wurde verwendet, hier in ChatGPT Pro – alternativ sind natürlich auch andere KI-Systeme wie Google Gemini Pro möglich:
| Extrahiere aus dem ChildLex Korpus unter https://osf.io/tqgjs/overview (Datei Download zip) die 50 häufigsten Wörter zum Themenbereich zu Hause/Familie. Es sollen 50 Wörter sein, die später in ein Situationsbild „Haus“ mit den Zimmern Wohnzimmer, Küche, Bad und Kinderzimmer passen. Es sollen kindgemäße Wörter sein, die zu einem Haus einer vierköpfigen Familie mit zwei Kindern passen. Es sollen die häufigsten Wörter der Kindersprache dargestellt werden. Erstelle eine Wortliste als Tabelle mit jeweils dem Wort sowie jeweils der gefundenen Häufigkeit aus ChildLex in zwei Spalten. In der Tabelle sollen sich die 50 häufigsten Wörter zu diesem Themenbereich „Haus“ befinden. |
Folgende Wortliste mit absoluten Häufigkeiten aus ChildLex (lemma.abs) entstand:
| Wort | Häufigkeit in ChildLex (lemma.abs) |
|---|---|
| Haus | 8.334 |
| Tür | 6.944 |
| Mutter | 6.072 |
| Vater | 5.229 |
| Junge | 4.294 |
| Mädchen | 4.124 |
| Boden | 3.936 |
| Zimmer | 3.325 |
| Bett | 3.316 |
| Buch | 3.314 |
| Fenster | 2.928 |
| Tisch | 2.843 |
| Wand | 1.993 |
| Bild | 1.764 |
| Küche | 1.674 |
| Treppe | 1.622 |
| Decke | 1.287 |
| Stuhl | 1.284 |
| Glas | 975 |
| Ball | 910 |
| Schrank | 788 |
| Teller | 678 |
| Schreibtisch | 649 |
| Wohnzimmer | 570 |
| Regal | 473 |
| Sofa | 456 |
| Messer | 453 |
| Teppich | 423 |
| Lampe | 375 |
| Sessel | 373 |
| Tasse | 365 |
| Topf | 357 |
| Kissen | 340 |
| Löffel | 268 |
| Kühlschrank | 250 |
| Puppe | 230 |
| Fernseher | 227 |
| Toilette | 197 |
| Badezimmer | 192 |
| Teddy | 185 |
| Handtuch | 182 |
| Gabel | 175 |
| Herd | 172 |
| Kinderzimmer | 158 |
| Dusche | 121 |
| Badewanne | 98 |
| Pfanne | 94 |
| Waschbecken | 86 |
| Spielzeug | 78 |
| Spüle | 49 |
Eine nochmalige Überprüfung der Ergebnisse per KI in einem zweiten Versuch führte zur selben Liste. Außerdem ergab die augenscheinliche Prüfung, dass die Wortauswahl gut gelang:
- Die Wortauswahl wirkt auf den ersten Blick passend und intuitiv.
- Noch häufigere, auch bildlich darstellbare Wörter aus ChildLex wie Hand, Kopf, … tauchen in der ausgegebenen Liste nicht auf und gehören nicht direkt zum gewünschten Themenfeld.
- Es werden immer die häufigsten Varianten von Wörtern genommen (also Tür statt Türe).
- Die in der Ergebnistabelle angegebenen Häufigkeiten stimmen mit denen in ChildLex überein.
- …
Spannend waren tatsächlich auch noch die Bemerkungen, mit denen das Ergebnis erläutert wurde:
- Verwendet wurde die absolute Lemma-Häufigkeit
lemma.absaus der ChildLex-Gesamttabelle über alle Altersgruppen von 6 bis 12 Jahren. Verschiedene Wortformen werden daher zusammengezählt. - Das Lemma für „Tür“ ist in den Daten ungewöhnlicherweise als „Türe“ geführt. Die Häufigkeit 6.944 umfasst unter anderem „Tür“, „Türe“ und „Türen“. Für das Situationsbild habe ich die üblichere Form „Tür“ gewählt.
- Die Auswahl ist semantisch kuratiert: Aus den zum Hausbild passenden, kindgemäßen und bildlich darstellbaren Begriffen wurden die häufigsten ausgewählt. Dadurch bleiben alle vier gewünschten Räume vertreten.
- ChildLex bildet streng genommen nicht die gesprochene Kindersprache ab, sondern die Schriftsprache, die Kinder in Kinder- und Schulbüchern lesen. Das Korpus umfasst etwa zehn Millionen Wörter. (ChildLex-Datensatz, Beschreibung der Datenbank)
- Interessant wäre als nächster Schritt allerdings eine inhaltliche Prüfung der Auswahl: also welche häufigen ChildLex-Wörter aus dem Bereich Haus/Familie möglicherweise fehlen, weil z. B. weniger typische Bildbegriffe wie Mama, Papa, Kind, Bruder, Schwester, Essen, trinken, schlafen, spielen bei der bisherigen Auswahl ausgeschlossen wurden. Damit ließe sich prüfen, ob diese 50 tatsächlich die optimale Wortschatzliste für das Situationsbild sind.
Nun soll die KI noch eine einfache Wortliste erzeugen, die dann als Grundlage für das Wimmelbild verwendet werden kann:
| Liste jetzt die 50 Wörter getrennt mit Komma auf! |
Es entsteht also folgend Wortliste:
Haus, Tür, Mutter, Vater, Junge, Mädchen, Boden, Zimmer, Bett, Buch, Fenster, Tisch, Wand, Bild, Küche, Treppe, Decke, Stuhl, Glas, Ball, Schrank, Teller, Schreibtisch, Wohnzimmer, Regal, Sofa, Messer, Teppich, Lampe, Sessel, Tasse, Topf, Kissen, Löffel, Kühlschrank, Puppe, Fernseher, Toilette, Badezimmer, Teddy, Handtuch, Gabel, Herd, Kinderzimmer, Dusche, Badewanne, Pfanne, Waschbecken, Spielzeug, Spüle
2. Aus der Wortliste ein Wimmelbild erstellen
Mit folgendem Prompt wird jetzt mit einer bildgenerierenden KI ein Wimmelbild erzeugt (z.B. ChatGpt, Google Gemini):
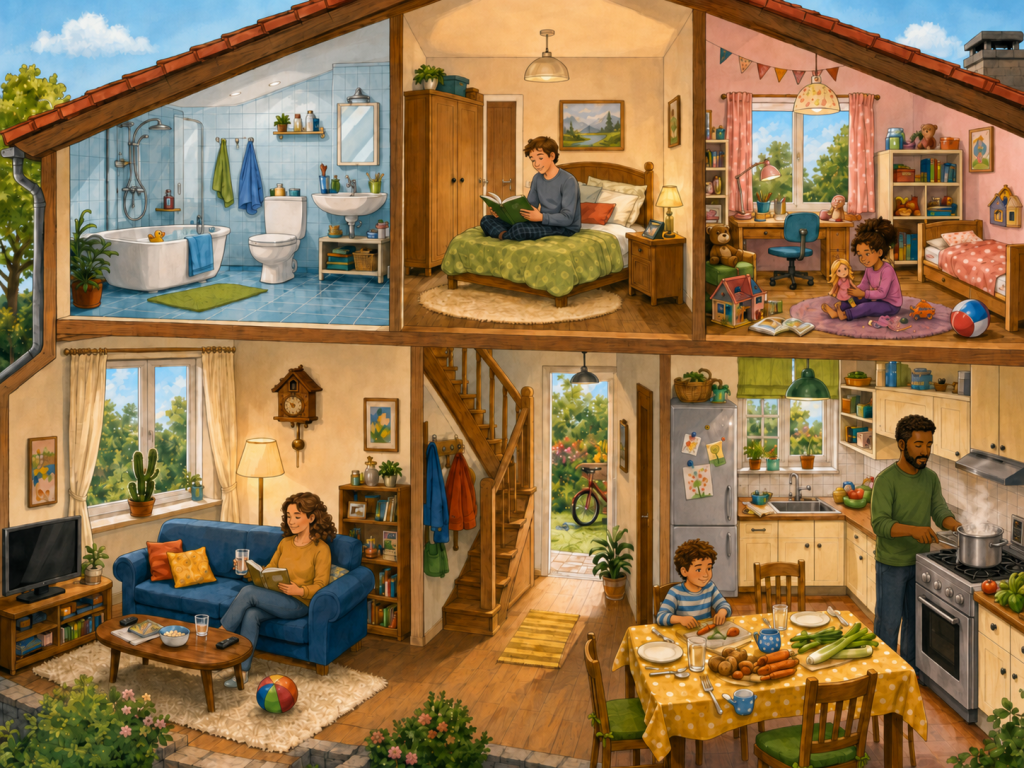
| Erstelle ein Wimmelbild im Querformat 4:3 im Stil eines Kinderbuchs für 6-10-jährige Kinder (Stil Kinderbuchzeichnung, gerne flächig, aber handgezeichnet, auch für ältere Kinder geeignet): Auf dem Wimmelbild sieht man eine Alltagssituation in einem Haus. Das Haus ist als Querschnitt mit verschiedenen Räumen dargestellt (Bad, Wohnzimmer, Schlafzimmer, Küche, Kinderzimmer). Die Räume sind klassisch wie in Familienwohnungen mit zwei Kindern gestaltet. Neben gängigen Einrichtungsgegenständen sollen folgende Dinge abgebildet sein: Haus, Tür, Mutter, Vater, Junge, Mädchen, Boden, Zimmer, Bett, Buch, Fenster, Tisch, Wand, Bild, Küche, Treppe, Decke, Stuhl, Glas, Ball, Schrank, Teller, Schreibtisch, Wohnzimmer, Regal, Sofa, Messer, Teppich, Lampe, Sessel, Tasse, Topf, Kissen, Löffel, Kühlschrank, Puppe, Fernseher, Toilette, Badezimmer, Teddy, Handtuch, Gabel, Herd, Kinderzimmer, Dusche, Badewanne, Pfanne, Waschbecken, Spielzeug, Spüle. Zusätzlich sollen außerdem folgende Dinge unbedingt im Bild vorkommen: Im Wohnzimmer ein Fenster mit einem Vorhang. Auf dem Fensterbrett steht ein Kaktus. An der Wand im Wohnzimmer hängt eine Kuckucksuhr. In der Küche liegt Gemüse auf der Küchenzeile oder dem Tisch, nämlich: Kartoffeln, Karotten, Sellerie und Lauch. Die Begriffe sollen im Bild dargestellt sein, aber nicht mit Schrift beschriftet sein. |
Es entstanden folgende zwei Wimmelbilder, wobei hier noch Spezial-Items eingebettet wurden, die später für die Überprüfung des Sprachverständnisses benötigt wurden (z.B. der Kaktus, die Kuckucks-Uhr):
Teilweise musste man noch nachhaken:
- Die Perspektive stimmte noch nicht: Der Papa stand im ChatGPT-Bild nicht neben dem Herd, sondern war im Herd quasi eingeschmolzen. Das ist aber immer noch nicht ganz perfekt, aber vielleicht auch interessanter Sprechanlass für die Förderung („Was stimmt nicht?“).
- Die Familie war noch nicht multinational bzw. bezog gerade Kinder mit Migrationshintergrund noch nicht ausreichend ein. Daher wurde hier nochmal nachgebessert mit einem Prompt.
- Gender-Vorurteile wurden zu sehr prototypisch unterstrichen, z.B. stand die Mama am Herd und kochte. Hier sollte mal der Papa kochen! Und die Mama sitzt am Sofa. OK, etwas uneigennützig. 🙂
Fazit
Die Kombination von ChildLex und ChatGPT eröffnet spannende, sehr zeitökonomische Möglichkeiten, auch in der Praxis korpus- und wissenschaftsbasiert Materialien zu erstellen, ohne sich lange mit manuellen Analysen beschäftigen zu müssen.
Die Ausgaben sollten aber unbedingt immer nochmal geprüft werden, denn KI kann Fehler machen, sowohl bei der Wortauswahl für die Liste als auch beim Zeichnen der Bilder.
Gerade Fehler in Bildern lassen sich aber auch didaktisch prima nutzen, indem man sie mit den Kindern bespricht: „Was stimmt denn da nicht?“, „Warum?“ Dabei kann man im Sinne der Medienerziehung bzw. Medienreflexion auch darauf eingehen, dass das Bild mit KI erstellt wurde: „Ich prüfe KI-Texte oder -Bilder immer kritisch!“. Kinder lernen dann gleich, dass sich so ein kritischer Blick lohnt.
Spannende weitere Anwendungsfelder könnten sein:
- Wortlisten erstellen zu Sachthemen, zur Vorentlastung von Gesprächen, Rollenspielen, …
- Wortlisten in Wimmelbilder oder Spiele mit Einzelbildern umwandeln, z.B. für Zwillingsbilder, Kartenspiele, Sammelkarten
- Arbeitsblätter auch in anderen Themenbereichen auf Häufigkeitswerten basierend erstellen, z.B. im Bereich phonologische Bewusstheit, Schriftspracherwerb, …
- Übungen erstellen zum Blitzlesen und Automatisierung der häufigsten 100 Wörter, …
- Häufigkeitswortschatz zu einem Sachthema finden und daraus Lesetexte erstellen
- Bewertung von Lesetexten, wobei es dazu wieder Spezialtools wie RATTE (Regensburger Analysetool für Texte, https://wild.shinyapps.io/ratte-new-r/): Hier kann man einen Text ins Analysefeld kopieren und dann wird eingeschätzt, ob er für die gewählte Jahrgangsstufe passt (grün, gelb, rot). Außerdem werden linguistische Kennwerte ausgegeben, z.B. seltene bzw. schwierige Wörter gekennzeichnet.
Nächster Schritt könnte sein, auch weitere Kinderkorpora für die Praxis zu nutzen, wobei ChildLex besonders leicht zugänglich und nutzbar ist.
Ich bin beeindruckt, was inzwischen alles möglich ist! Habt ihr noch Ideen zu diesem Bereich? Schreibt es gerne in die Kommentare! Ich freue mich sehr über Austausch!
 Dr. Karin Reber

Hinterlasse einen Kommentar